AI 기능, 데모는 되는데 운영에서 멈추는 이유: 납품 전 8가지 점검
데모에서 잘 되던 AI 기능이 운영에서 멈추는 이유는 대개 모델이 아니라 운영 장치에 있습니다. 납품 전에 확인할 8가지와 AI 게이트웨이가 덜어 주는 부분을 나눠 정리했습니다.
AI 기능이 운영에서 멈추는 이유는 대개 프롬프트가 아니라 그 바깥의 운영 장치에 있습니다. 납품 전에 원본 저장, 지연, 중복 호출, 실패 재처리, 캐싱, 대체 경로, 사용량·비용 한도, 운영 지표 8가지를 시험으로 확인해야 합니다.
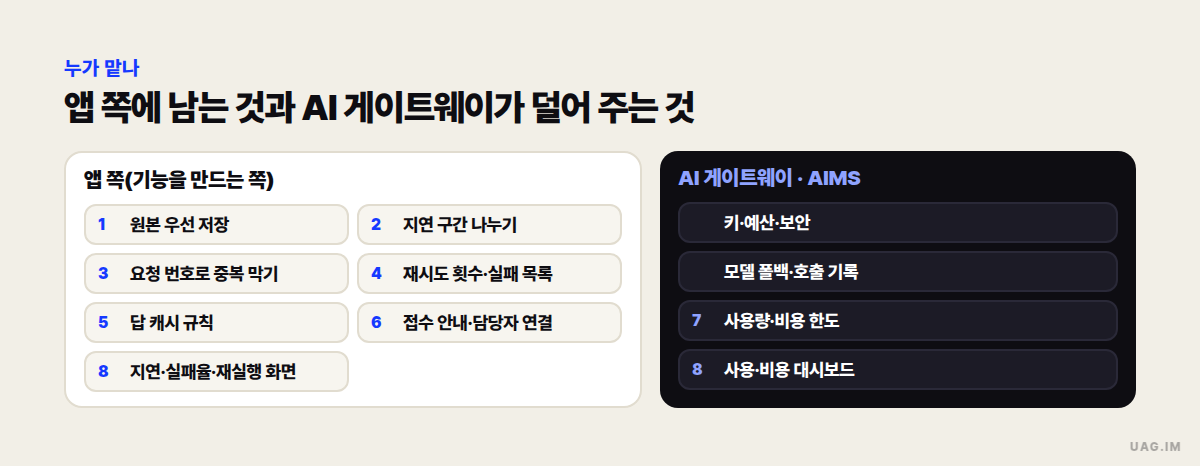
이 중 모델을 부르는 쪽의 공통 장치(키·예산·폴백·사용량 한도)는 AI 게이트웨이에서 한 번에 다룰 수 있고, 나머지는 기능을 만드는 앱 쪽에 남습니다. 조직 쪽 이유(데이터·담당자·성과 지표)는 PoC에서 운영까지 — 살아남는 10%는 무엇이 다른가에서 다뤘고, 이 글은 기능 자체의 운영 장치를 봅니다.
왜 데모에서는 문제가 보이지 않나요?
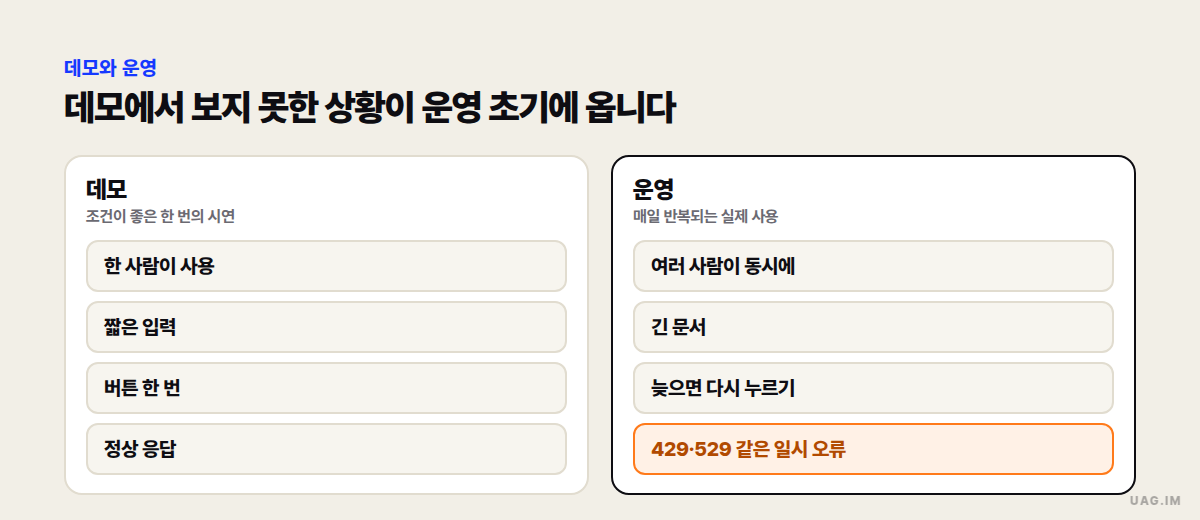
데모는 한 사람이 짧은 입력을 넣고 버튼을 한 번 누르는 조건입니다. 운영에서는 여러 사람이 동시에 쓰고, 긴 문서가 들어오고, 응답이 늦으면 버튼을 다시 누릅니다.
모델 공급사 문서도 일시적인 실패와 그 대응을 적어 둡니다. Anthropic의 Claude API 문서는 요청 한도를 넘으면 429, API가 일시적으로 과부하이면 529 오류를 돌려준다고 적고, 500 오류는 지수 백오프(재시도 간격을 점점 늘리는 방식)로 다시 시도하라고 안내합니다(Claude API errors). OpenAI 문서도 429 응답에 Retry-After 헤더로 기다릴 시간을 알려 줄 수 있다고 적습니다(OpenAI Rate limits).
그래서 점검은 "답이 맞는가"보다 "실패했을 때 무엇이 남는가"에서 시작합니다.
납품 전 8가지 점검은 무엇인가요?
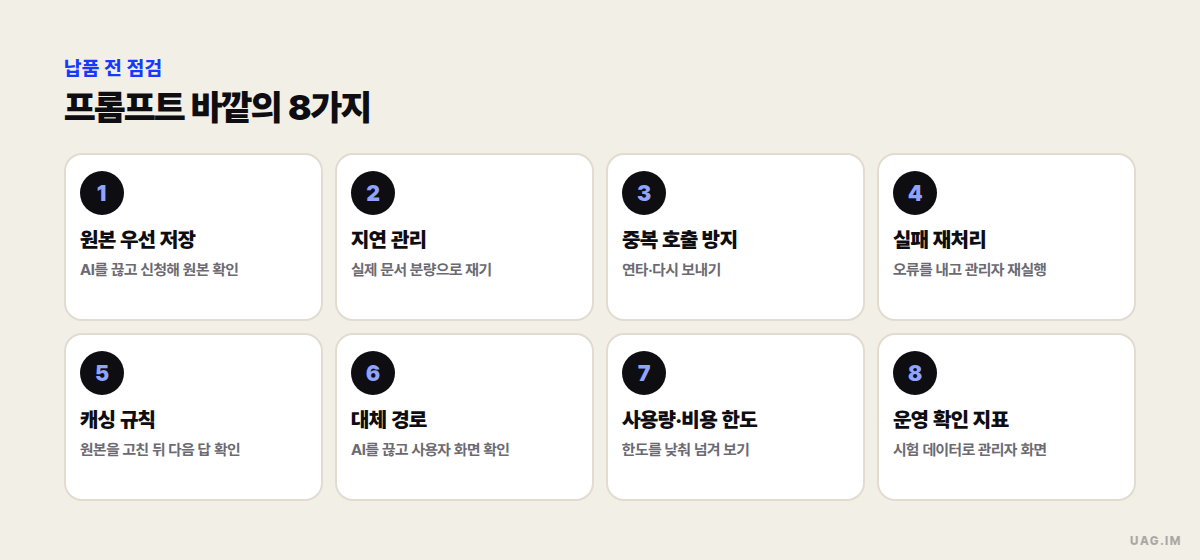
유에이지는 고객에게 납품하는 AI 기능의 범위·설계·테스트·인계에 아래 8가지를 넣는 것을 기준으로 삼고 있습니다. 몇 초, 몇 번 같은 기준값은 기능마다 다르므로 실제 문서와 사용자로 시험한 뒤 고객과 합의해 정합니다.
| # | 점검 | 막으려는 사고 | 납품 전 시험 |
|---|---|---|---|
| 1 | 원본 우선 저장 | AI 오류로 사용자 입력이 사라짐 | AI를 끊고 신청한 뒤 원본이 남았는지 확인 |
| 2 | 지연 관리 | 기다리다 이탈하거나 다시 누름 | 실제 문서 분량으로 재기 |
| 3 | 중복 호출 방지 | 비용·알림·결과가 두 번 생김 | 버튼 연타, 같은 요청 다시 보내기 |
| 4 | 실패 재처리 | 실패한 건이 조용히 묻힘 | 오류를 일부러 내고 관리자 재실행 |
| 5 | 캐싱 규칙 | 지난 가격·지난 규정으로 답함 | 가격표·지식을 고친 뒤 다음 답 확인 |
| 6 | 대체 경로 | AI 장애 때 서비스 전체가 멈춤 | AI를 끊고 사용자 화면 확인 |
| 7 | 사용량·비용 한도 | 비용 폭주, 원인 추적 불가 | 한도를 낮춰 놓고 넘겨 보기 |
| 8 | 운영 확인 지표 | 고객이 먼저 장애를 알림 | 시험 데이터로 관리자 화면 확인 |
입력은 어떻게 지키고, 장애 때는 무엇을 보여 주나요?
1번과 6번은 한 쌍입니다. AI를 부르기 전에 사용자가 넣은 원본을 먼저 저장하면, 모델이 실패해도 신청서·문의·문서는 남습니다. 장애 때는 "접수됐습니다, 준비되면 알려 드립니다" 안내나 담당자 연결로 넘깁니다.
둘이 없으면 모델의 일시 오류가 곧 자료 유실이 되고, 둘이 있으면 AI가 멈춰도 업무는 접수까지 이어집니다.
기다림과 중복 호출은 어떻게 다루나요?
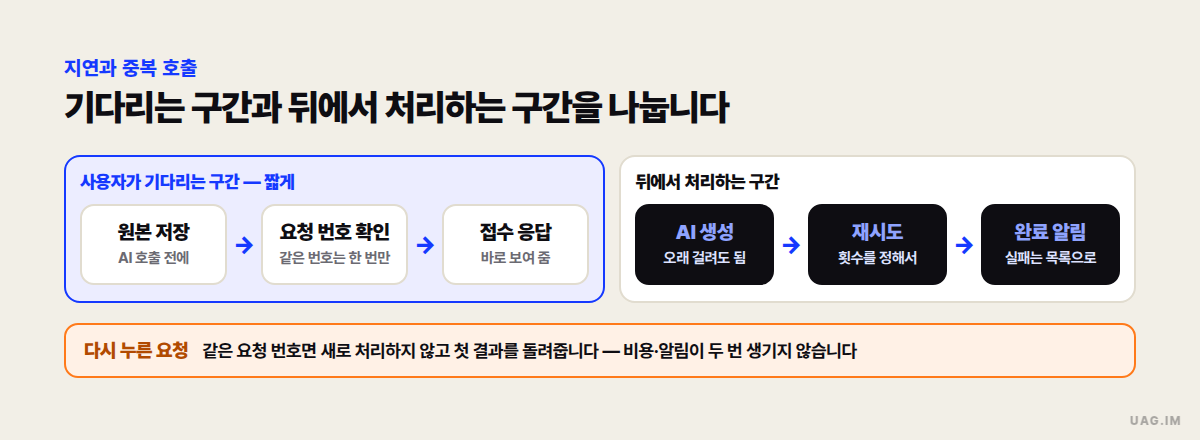
2번 지연은 사용자가 기다리는 구간과 뒤에서 처리하는 구간을 나누는 설계 문제입니다. 대화형은 첫 응답이 빨리 보이게 하고, 보고서처럼 오래 걸리는 생성은 접수 즉시 응답한 뒤 뒤에서 만듭니다. Claude API 문서도 오래 걸리는 요청에는 스트리밍(답을 만들어지는 대로 조금씩 보내는 방식)을 쓰라고 안내합니다.
3번 중복 호출은 지연에서 생깁니다. 응답이 늦으면 사람은 다시 누르고, 네트워크가 끊기면 프로그램이 다시 보내 비용과 알림이 두 번 생깁니다. 이를 막는 방법으로 결제 API에서 쓰는 것이 요청 번호(멱등 키)입니다. Stripe 문서는 요청에 고유한 키를 붙이면 연결 오류 뒤 다시 보내도 같은 작업이 두 번 실행되지 않는다고 설명합니다(Stripe Idempotent requests). AI 기능도 같은 요청 번호는 한 번만 처리하게 만듭니다.
실패한 요청은 몇 번 다시 보내고, 무엇을 캐시하나요?
4번 재처리는 "무한히 다시 보내기"가 아닙니다. Claude 공식 SDK(개발용 라이브러리)는 연결 오류·요청 한도·5xx(500번대 서버 오류) 같은 일시적 실패를 기본 2번까지 다시 시도합니다. OpenAI 문서는 재시도 횟수와 전체 시간을 함께 제한하고, 앱이 재시도를 맡으면 SDK 재시도를 끄거나 그 횟수를 앱의 한도에 포함하라고 적습니다. 할당량 소진이나 결제 문제처럼 사람이 조치해야 하는 오류는 재시도하지 말라고 안내합니다.
그래서 재시도는 횟수를 정해 두고, 그래도 실패한 건은 실패 목록에 올려 관리자가 다시 실행하게 합니다.
5번 캐싱은 두 가지를 구분합니다. 모델 공급사의 프롬프트 캐싱은 반복되는 입력 앞부분을 다시 쓰는 기능으로, Claude API 문서에 따르면 글자까지 똑같은 구간에서만 쓰이고 기본 수명은 5분이며 받는 답은 캐시가 없을 때와 같습니다(Prompt caching). 반면 앱이 답 자체를 저장해 다시 내보내는 캐시는 규칙이 필요합니다. 바뀌지 않는 지식만 캐시하고, 사람마다 다른 답은 캐시하지 않고, 가격표·규정 같은 원본이 바뀌면 바로 지웁니다. 캐시가 낡으면 모델이 제대로 작동해도 답이 틀립니다.
사용량 한도와 운영 지표는 무엇으로 보나요?
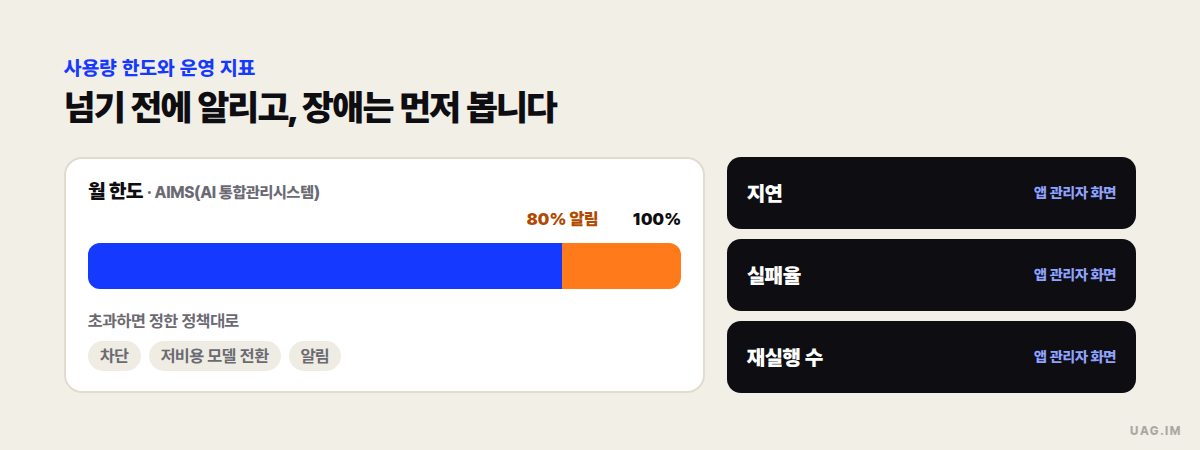
7번은 건별 사용량 기록, 일·월 한도, 한도 근처의 알림입니다. OpenAI 문서도 사용자별 일·주·월 한도와, 넘을 때의 강제 차단이나 사람 검토를 권합니다. 8번은 지연·실패율·재실행 수와 사용·비용을 관리자가 먼저 보는 화면입니다.
7번의 건별 기록·월 한도·알림과 8번 중 사용·비용 관제는 AI 통합관리시스템(AIMS)이 맡습니다. AIMS는 구독 좌석·API 사용자·예산·사용 기록을 한 콘솔에서 관리하는 체계로, 실시간 사용·비용 대시보드로 누가 어떤 모델을 얼마나 쓰는지 보고, 계정·부서·기관 단위 월 한도의 80%에 다다르면 알림을 보냅니다. 초과하면 차단, 저비용 모델 전환, 알림 중 정한 정책대로 동작하고, 이상 사용·급증은 감지해 경고합니다. 지연·실패율·재실행 수는 기능을 만드는 앱의 관리자 화면에 둡니다.
AI 게이트웨이는 8가지 중 무엇을 덜어 주나요?
AI 게이트웨이는 앱과 여러 모델 사이에 두는 하나의 관문으로, 모델 호출 쪽 공통 장치를 기능마다 새로 만들지 않고 한곳에 모읍니다.
- 키·예산·보안: 관리형 AI 게이트웨이는 여러 프로바이더의 계약·키·요금을 UAG.IM이 대신 보유하고, 예산 한도와 개인정보 마스킹, 감사 로그를 하나의 운영 체계로 맡습니다.
- 대체 모델: 멀티 모델 라우팅 엔진은 선택한 모델이 실패하면 다음 후보로 폴백하고, 어떤 요청이 왜 그 모델로 갔는지 호출 사유와 비용을 함께 기록합니다.
- 한도·관제: 7번의 월 한도와 사용·비용 대시보드는 AIMS가 맡습니다.
앱 쪽에는 원본 우선 저장(1), 지연 구간 나누기(2), 요청 번호로 중복 막기(3), 재시도 횟수와 실패 목록(4), 답 캐시의 규칙(5), 접수 안내·담당자 연결(6), 지연·실패율·재실행 수 화면(8)이 남습니다. 나중에 고객 명의의 다른 API로 옮길 가능성이 있다면, 재시도·캐시·한도 처리를 앱 쪽에 두어 옮긴 뒤에도 같은 동작이 나오게 합니다.
직접 만들지 관리형으로 맡길지는 AI Gateway 구축, 직접 할까 관리형으로 맡길까에서 비교했습니다.
납품 전에는 어떻게 시험하나요?
정상 동작 시험과 별도로, 납품 전에 네 가지를 일부러 일으켜 봅니다.
- AI 끊기 — 원본이 남고 사용자 화면에 접수 안내가 나오는지 봅니다.
- 연타·재전송 — 처리와 비용이 한 번만 남는지 봅니다.
- 원본 바꾸기 — 가격표나 지식 문서를 고친 뒤 다음 답이 바뀐 내용을 쓰는지 봅니다.
- 한도 넘기기 — 한도를 낮춰 놓고 알림과 초과 뒤 동작이 정한 대로인지 봅니다.
인계 때는 장애 때 할 일을 운영 매뉴얼에 넣고, 담당자가 전체 흐름을 설명할 수 있는지 확인합니다. 일정이나 예산 때문에 줄여야 한다면 시험보다 기능을 먼저 덜어 냅니다.
자주 묻는 질문
AI 기능이 데모에서는 되는데 운영에서 멈추는 이유는 무엇인가요?
대개 프롬프트가 아니라 운영 장치가 없어서입니다. 운영에서는 동시 사용, 긴 입력, 다시 누르기, 일시적인 API 오류가 함께 오므로 원본 저장·중복 호출 방지·재처리·대체 경로가 필요합니다.
AI 게이트웨이를 쓰면 8가지가 모두 해결되나요?
아닙니다. 키·예산·보안, 모델 폴백, 사용량 한도와 사용·비용 대시보드처럼 모델 호출 쪽 공통 장치는 게이트웨이와 AIMS에서 다룰 수 있습니다. 원본 우선 저장, 지연 구간 나누기, 요청 번호로 중복 막기, 재시도와 실패 목록, 사용자 화면의 대체 안내, 답 캐시 규칙, 지연·실패율·재실행 수 화면은 기능을 만드는 앱 쪽에서 설계해야 합니다.
프롬프트 캐싱을 쓰면 답이 낡을 수 있나요?
모델 공급사의 프롬프트 캐싱은 똑같은 입력 앞부분을 다시 쓰는 기능이라 받는 답은 캐시가 없을 때와 같습니다. 답이 낡는 문제는 앱이 답을 저장해 다시 내보낼 때 생기므로, 원본이 바뀌면 그 캐시를 바로 지웁니다.