멀티 LLM 라우팅, 질문마다 모델 고르는 기준
모든 질문을 같은 모델로 보내면 비용이 새거나 품질이 모자랍니다. 멀티 LLM 라우팅에서 질문마다 모델을 고르는 다섯 가지 기준과, 그 기준을 라우팅 규칙으로 바꾸고 평가 세트로 확인하는 순서를 정리했습니다.
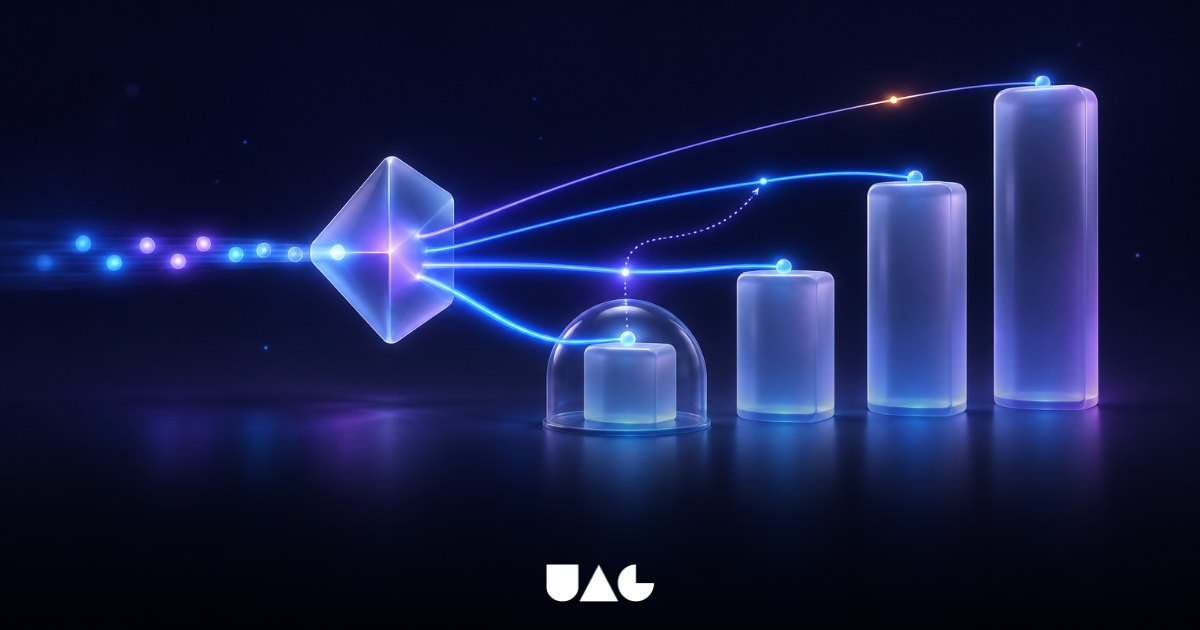
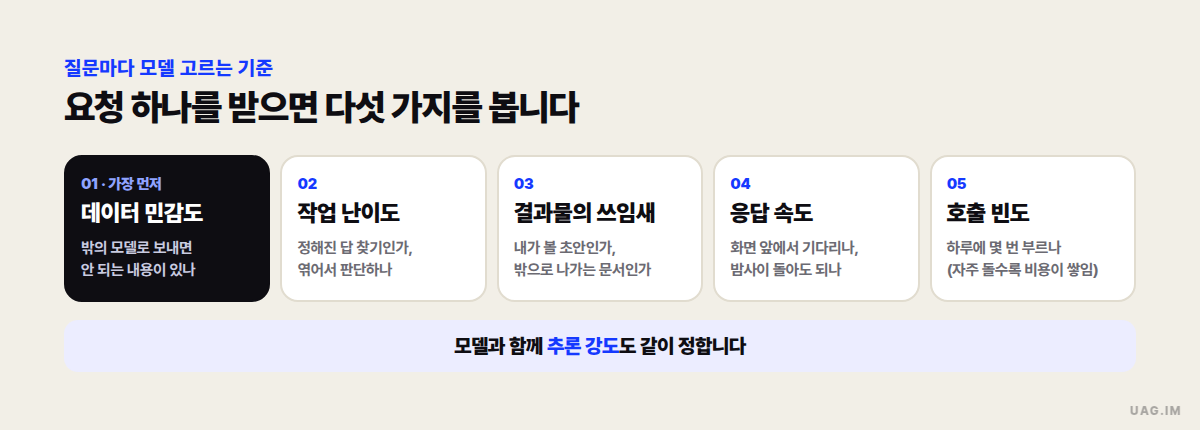
멀티 LLM 라우팅에서 질문마다 모델을 고르는 기준은 다섯 가지입니다. 데이터 민감도, 작업 난이도, 결과물의 쓰임새, 응답 속도, 호출 빈도입니다. 민감한 데이터는 먼저 로컬로 보내고, 나머지는 품질 기준을 넘는 가장 가벼운 모델로 보내며, 그 기준은 우리 업무 질문으로 만든 평가 세트로 확인합니다.
멀티 LLM 플랫폼으로 여러 모델을 한 API로 묶고 나면 다음 질문이 남습니다. "그래서 이 요청은 어느 모델로 보내야 하나?"입니다. 이 글은 사내 AI 사용을 맡은 중견·대기업의 IT·경영지원·AX 담당자와 기관의 정보화 담당자가 멀티 모델 라우팅 규칙을 처음 세울 때 쓸 기준과 순서를 정리합니다.
질문마다 모델을 왜 따로 고르나요?
모든 요청을 같은 모델로 보내면 둘 중 하나가 생깁니다. 쉬운 일에 비싼 모델을 써서 비용이 새거나, 어려운 일에 가벼운 모델을 써서 품질이 모자랍니다.
같은 회사의 모델 사이에서도 가격 차이는 큽니다. Anthropic 공식 가격표를 보면 입력 100만 토큰당 Claude Opus 5.5는 4달러, Claude Haiku 5.5는 0.10달러(프롬프트 10만 토큰 이하 기준)로 40배 차이가 납니다(Claude Models overview·Claude Pricing, 2026-11-17 확인). 같은 문서는 Haiku 5.5를 분류·추출·라우팅처럼 양이 많고 빠른 응답이 필요한 일에 맞는 모델로 소개합니다.
그렇다고 무조건 싼 모델이 답은 아닙니다. OpenAI의 모델 선택 안내는 같은 입력으로 비교해 품질 기준을 넘는 가장 가벼운 설정을 남기라고 권합니다(OpenAI Model selection). Anthropic 안내도 가벼운 모델로 시작해 필요할 때만 올리거나, 강한 모델로 시작해 추론 강도·모델을 낮춰 가는 두 가지 방법을 제시합니다.
모델을 고르는 다섯 가지 기준은 무엇인가요?
요청 하나를 받았을 때 아래 다섯 가지를 봅니다.
- 데이터 민감도: 개인정보·사내 기밀처럼 밖의 모델로 보내면 안 되는 내용이 들어 있나요? 그렇다면 다른 기준보다 먼저 이것으로 갈 곳이 정해집니다.
- 작업 난이도: 분류·추출처럼 답이 정해진 일인가요, 여러 자료를 엮어 판단해야 하는 일인가요?
- 결과물의 쓰임새: 내가 다시 볼 초안인가요, 고객·기관에 그대로 나가는 문서인가요? OpenAI 안내도 검토용 초안은 밖에 내보낼 결과물만큼 다듬지 않아도 될 수 있다고 봅니다.
- 응답 속도: 사람이 화면 앞에서 기다리는 일인가요, 밤사이 돌아도 되는 일인가요?
- 호출 빈도: 하루에 몇 번 부르나요? 자주 도는 자동화일수록 사용량과 비용이 빨리 쌓입니다.
Anthropic의 모델 선택 안내도 기능·속도·비용을 먼저 따지라고 하고, 여러 Claude 모델은 한 모델 안에서 추론 강도(effort)를 조절할 수 있어, 모델을 바꾸기 전에 이 값을 먼저 조절하는 편이 나은 경우가 많다고 설명합니다(Claude Choosing the right model). 라우팅 규칙에도 "어느 모델"과 함께 "어느 강도"를 같이 적어 두면 좋습니다.
기준을 라우팅 규칙으로 바꾸려면 어떻게 하나요?
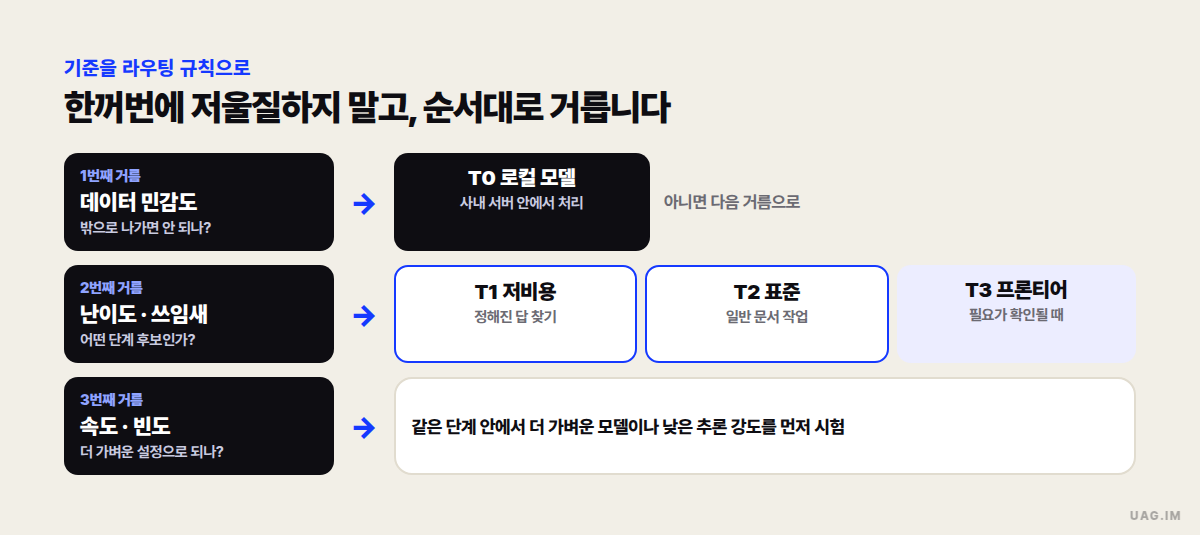
다섯 기준을 한꺼번에 저울질하면 규칙이 복잡해집니다. 순서를 정해 하나씩 거르면 단순해집니다.
- 민감도로 먼저 거릅니다. 밖으로 나가면 안 되는 데이터가 든 요청은 사내 서버의 로컬 모델로 보냅니다.
- 난이도와 쓰임새로 단계를 정합니다. 정해진 답을 찾는 일은 저비용 단계, 일반 문서 작업은 표준 단계, 여러 자료를 엮어 판단하거나 밖으로 나갈 중요한 결과물은 상위 단계 후보로 둡니다.
- 속도와 빈도로 다듬습니다. 같은 단계 안에서도 자주 부르거나 바로 답해야 하는 일은 더 가벼운 모델이나 낮은 추론 강도를 먼저 시험합니다.
UAG.IM의 멀티 모델 라우팅 엔진은 갈 곳을 T0~T3 네 단계로 나눕니다. 아래 표의 업무 예시는 회사 업무에 맞춰 든 설계 예시이며, 실제 배정은 평가 결과로 정합니다.
| 단계 | 어디로 | 이런 요청 | 업무 예시(설계 예시) |
|---|---|---|---|
| T0 | 로컬 모델 | 민감하거나 비용을 낮춰야 하는 요청 | 사내 기밀이 든 문서 요약, 개인정보가 든 민원 분류 |
| T1 | 저비용 모델 | 일상 처리 | 문의 메일 분류, 표에서 항목 뽑기, 태그 달기 |
| T2 | 표준 모델 | 범용 작업 | 회의록 정리, 보고서 초안, 사내 안내문 |
| T3 | 프론티어 모델 | 고난도 작업, 필요가 확인될 때 | 여러 자료를 엮은 분석, 밖으로 나갈 중요한 문서 검토 |
T3는 "필요가 확인될 때"만 씁니다. 상위 모델이 꼭 필요한 일인지 평가로 보인 뒤에 올리는 것이 비용을 지키는 방법입니다.
기준이 맞는지는 어떻게 확인하나요?
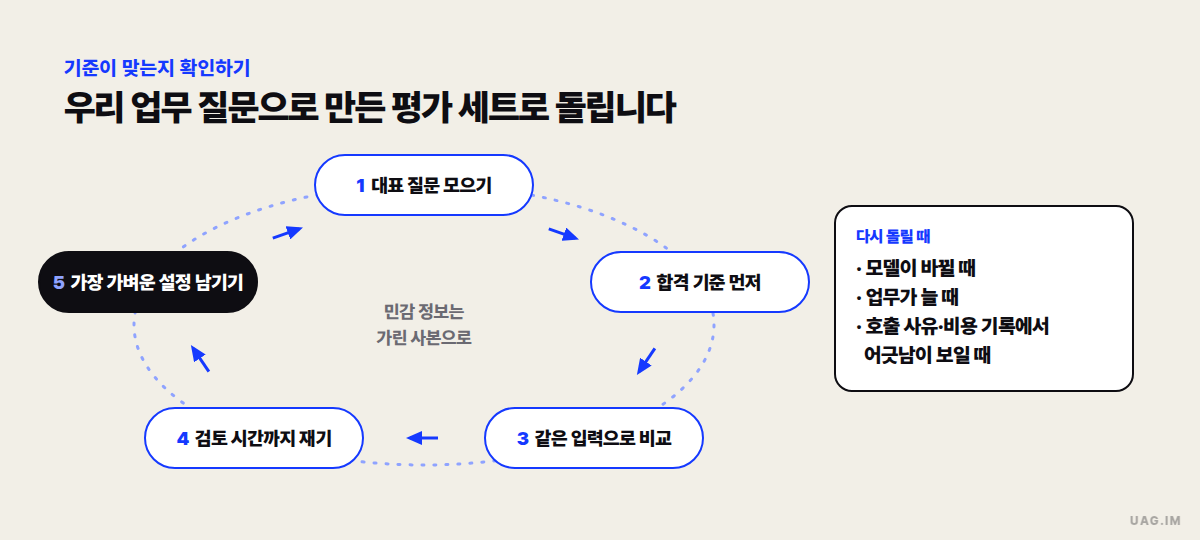
규칙을 세웠다면 우리 업무 질문으로 확인합니다. Anthropic 안내는 모델을 바꿀지 정할 때 쓰임새에 맞는 평가 세트를 만드는 것이 가장 중요한 단계라고 말합니다. 확인은 다섯 단계로 합니다.
- 대표 질문 모으기: 단계별로 실제 업무에서 자주 나오는 질문을 모읍니다. 민감 정보는 가린 사본을 씁니다.
- 합격 기준 먼저 정하기: 모델을 비교하기 전에 "필요한 사실이 들어 있나, 대상 독자에 맞나" 같은 기준을 정합니다(OpenAI 안내도 비교 전에 합격 기준을 먼저 정하라고 권합니다).
- 같은 입력으로 비교하기: 같은 질문을 후보 모델·추론 강도에 넣고 결과를 나란히 봅니다.
- 시간까지 재기: 답이 나오는 시간뿐 아니라 사람이 결과를 검토하고 고치는 시간까지 함께 봅니다.
- 가장 가벼운 설정 남기기: 합격 기준을 넘는 설정 가운데 가장 가벼운 것을 규칙에 적고, 모델이 바뀌거나 업무가 늘면 다시 돌립니다.
모델이 실패하거나 예산이 넘으면 어떻게 하나요?
라우팅 규칙에는 "평소에 어디로 보낼지"와 함께 "안 될 때 어디로 보낼지"가 들어가야 합니다.
- 폴백: 고른 모델이 응답하지 않거나 오류를 내면 다음 후보 모델로 넘겨 요청이 끊기지 않게 합니다.
- 호출 사유 기록: 어떤 요청이 왜 그 모델로 갔는지 사유와 비용을 함께 남겨야 나중에 규칙을 고칠 근거가 생깁니다.
- 예산 한도: 부서·계정 단위로 월 한도를 두고, 다 쓰기 전에 알림을 받고, 넘으면 어떻게 할지(차단, 저비용 모델로 전환, 알림) 미리 정합니다.
납품한 AI 기능이 운영에서 멈추지 않게 하는 점검 항목은 AI 기능, 데모는 되는데 운영에서 멈추는 이유: 납품 전 8가지 점검에서 더 자세히 다뤘습니다.
clrouter와 AIMS에서는 어떻게 하나요?
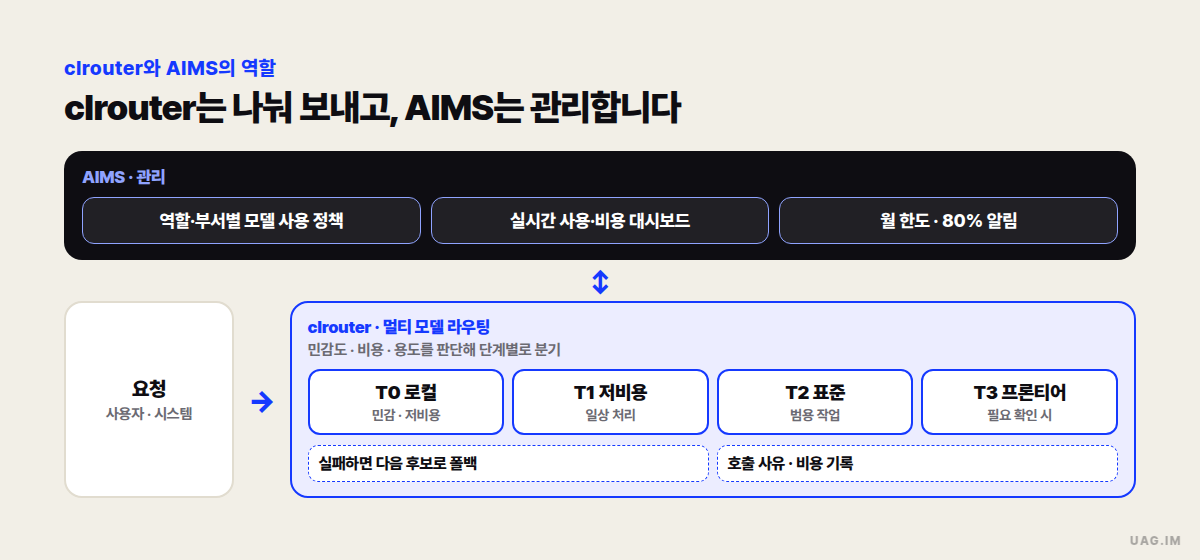
UAG.IM의 라우터 서비스 clrouter는 멀티 모델 라우팅 엔진으로 요청의 민감도·비용·용도를 판단해 로컬(T0)부터 프론티어(T3)까지 나눠 보냅니다.
- 단계별 분기: 민감하거나 비용을 낮춰야 하는 요청은 로컬 모델로, 고난도 작업은 프론티어 모델로 보냅니다.
- 폴백: 선택한 모델이 실패하면 다음 후보로 넘겨 요청이 끊기지 않게 합니다.
- 근거 기록: 어떤 요청이 왜 그 모델로 갔는지 호출 사유와 비용을 함께 기록합니다.
- 프로바이더 종속 줄이기: 여러 프로바이더를 하나의 라우팅 계층으로 묶습니다.
라우팅을 회사 운영 체계 안에서 관리하는 일은 AI 매니지먼트 시스템(AIMS)이 맡습니다. 역할·부서별로 쓸 수 있는 모델·기능을 정책으로 정하고, 실시간 사용·비용 대시보드로 누가 어떤 모델을 얼마나 쓰는지 봅니다. 계정·부서·기관 단위로 월 한도를 걸어 80%에 다다르면 알리고, 넘으면 차단·저비용 모델 전환·알림 가운데 정한 정책대로 움직입니다.
어떤 업무를 어느 단계로 보낼지는 회사마다 다르므로, 첫 상담에서 지금 쓰는 모델과 대표 업무를 함께 보고 정합니다.
처음에는 무엇부터 하면 되나요?
처음부터 모든 요청에 규칙을 걸지 않아도 됩니다. 아래 다섯 가지를 정하면 첫 규칙을 세울 수 있습니다.
- 지금 AI를 쓰는 업무 목록과 업무별 호출 빈도
- 밖으로 보내면 안 되는 데이터의 범위(로컬로 보낼 기준)
- 업무별 합격 기준과 대표 질문 몇 개씩
- 단계별 후보 모델과 추론 강도
- 실패 시 넘길 다음 후보와 부서별 월 한도
자주 묻는 질문
멀티 LLM 라우팅이란 무엇인가요?
여러 AI 모델을 묶어 쓰는 환경에서 요청마다 어느 모델로 보낼지 정해 나눠 보내는 일입니다. 데이터 민감도·작업 난이도·결과물의 쓰임새·응답 속도·호출 빈도를 기준으로 로컬 모델부터 프론티어 모델까지 단계를 나눕니다.
무조건 싼 모델로 보내면 비용이 가장 적게 드나요?
꼭 그렇지는 않습니다. 가벼운 모델이 합격 기준을 넘지 못하면 사람이 검토하고 고치는 시간이 늘어납니다. 같은 입력으로 비교해 합격 기준을 넘는 설정 가운데 가장 가벼운 것을 고르고, 답이 나오는 시간과 검토 시간까지 함께 봅니다.
라우팅 기준은 한 번 정하면 끝인가요?
아닙니다. 모델이 바뀌거나 업무가 늘면 평가 세트를 다시 돌려 기준을 고칩니다. 어떤 요청이 왜 그 모델로 갔는지 호출 사유와 비용을 기록해 두면 고칠 근거가 됩니다.